
SAM Audio Small · 两次实测评估
用同一个文字提示 people speaking,SAM Audio Small 能否把混合音频拆成说话声和其余声音?这次在一张 NVIDIA GeForce RTX 4090 D 上完成了两次实验,素材分别是 18.74 秒的短片和 160.24 秒的长音频。数据来自 2026 年 11 月 13 日的报告快照。
两次任务都跑通,听感仍待评审
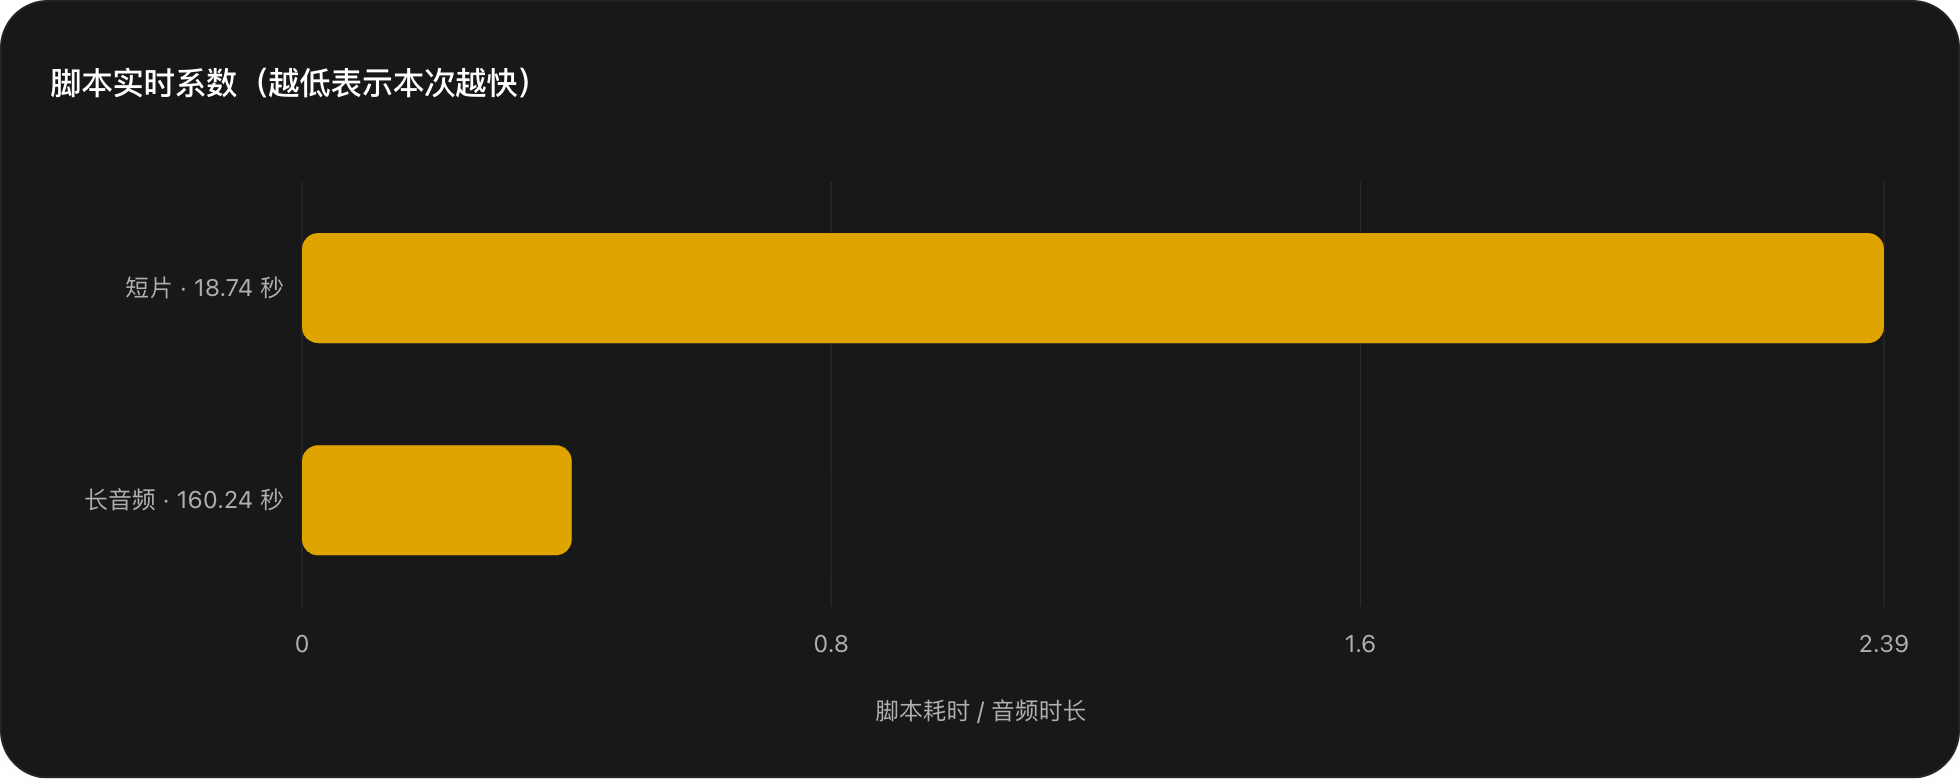
两次 GPU1 任务均以退出码 0 结束。输入和两条输出轨的 SHA-256 与运行清单一致,输出 WAV 可以完整解码。长音频分成 9 个重叠窗口,脚本耗时 65.36 秒,实时系数为 0.41。
这份报告验证了推理链路和文件完整性。人声残留、背景声保真和窗口接缝仍需人工试听。两次实验使用不同素材和脚本,耗时差异无法单独归因于输入长度。
模型与实验设置
Meta 的 SAM Audio 支持文字、视觉对象和时间片段提示。本次只使用文字提示 people speaking。模型生成两条音轨,target 是它识别出的目标说话声,residual 是剩余声音,也是本次去人声的结果。
- 使用 SAM Audio Small 固定模型修订版,权重文件 5.10 GB(4.75 GiB),约 13.85 亿参数,另有约 587 MiB 的 T5 缓存。
- 输入统一为 48 kHz、单声道、16-bit PCM WAV。随机种子为 0,关闭自动跨度预测,候选数为 1。两次实验都在单卡运行。
- 短片整段分离。长音频使用 20 秒窗口,相邻重叠 2 秒,在重叠区加权拼接,再按输入样本数裁剪。
运行速度与显存
| 素材 | 输入(秒) | 脚本(秒) | RTF | 提交至归还(分钟) | 峰值分配 / 预留(GiB) | 输出时长差(毫秒) |
|---|---|---|---|---|---|---|
| 短片 | 18.737 | 44.81 | 2.39 | 210.2 | 10.373 / 11.291 | +22.938 |
| 长音频 | 160.235 | 65.36 | 0.41 | 156.6 | 10.696 / 12.377 | 0.000 |
调度时间(北京时间)
- 短片 · 11/10 18:19:15 提交,11/10 21:49:26 归还
- 长音频 · 11/13 02:30:39 提交,11/13 05:07:14 归还
RTF 是脚本耗时除以输入时长,小于 1 表示本次处理快于实时。脚本耗时包含模型加载、推理和写盘。提交至归还还包括排队与资源交接。显存数字是 PyTorch 进程的峰值。
输出技术检查
六条 WAV 均为 48 kHz 单声道 PCM 16-bit,逐样本检查均无削波。
| 素材 | 轨道 | 时长(秒) | RMS(dBFS) | 峰值(dBFS) | 削波 | 清单哈希 |
|---|---|---|---|---|---|---|
| 短片 | 原声 | 18.737 | -42.24 | -16.90 | 0% | 一致 |
| 短片 | 分离人声 | 18.760 | -45.25 | -27.65 | 0% | 一致 |
| 短片 | 去人声 | 18.760 | -46.34 | -17.20 | 0% | 一致 |
| 长音频 | 原声 | 160.235 | -15.58 | -0.55 | 0% | 一致 |
| 长音频 | 分离人声 | 160.235 | -22.52 | -0.07 | 0% | 一致 |
| 长音频 | 去人声 | 160.235 | -17.20 | -0.29 | 0% | 一致 |
电平、削波和解码检查用于核对文件的技术状态。评估去人声效果,需要对齐原声和两条输出,分别听说话声残留、背景损失和长音频拼接处。
应用判断
两次 GPU1 实验验证了单卡加载、分离与文件输出。报告快照中的 GPU0 复测仍在排队。正式采用前,还需要补齐人工听评、更多声景与重复运行、并发与异常恢复验证,并审查模型来源及 SAM License 的适用范围。
运行数据来自调度终态和脚本清单。报告使用逐样本 PCM 统计、SHA-256 和完整解码核对输出。
SAM Audio 官方仓库 · Meta 技术介绍 · Small 模型页与许可
试听对比
以下为原报告的 96 kbps MP3 试听版。技术校验使用原始 WAV。